

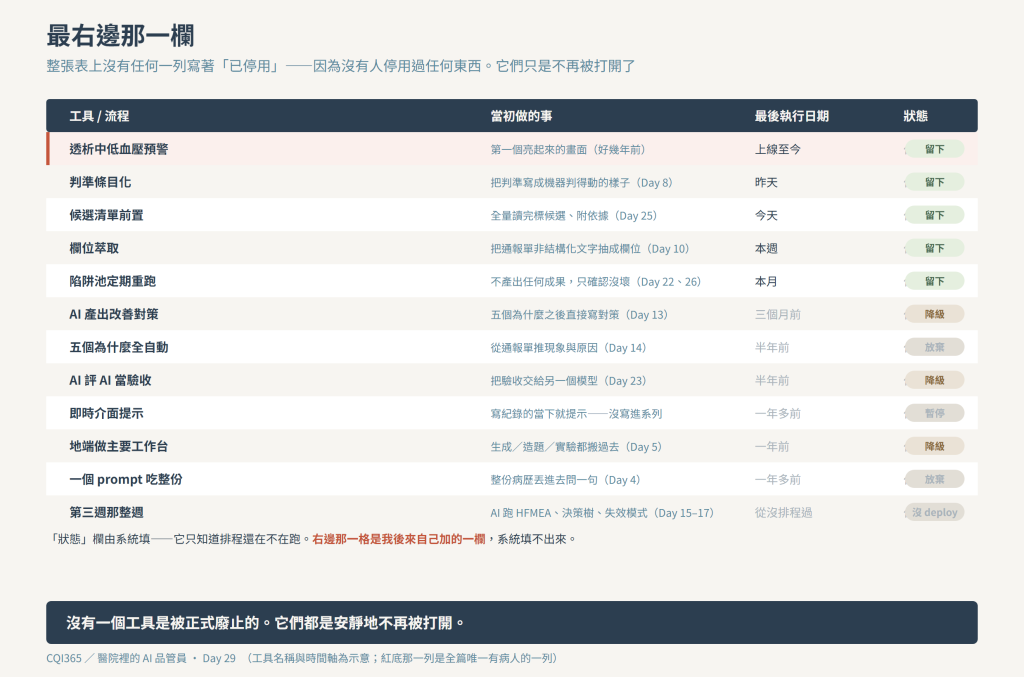
年度盤點的時候,品管與資訊一起檢視這段時間累積的流程。我參與討論時,特別在意表上最右邊那一欄——最後一次執行的日期。執行紀錄由資訊同仁核對,使用單位則要確認輸出後來有沒有被拿去做事。
表上有二十幾列:有些是昨天,有些是這週,有幾列停在很久以前,久到我要想一下那東西當初是拿來幹嘛的。
而整張表上沒有任何一列寫著「已停用」——因為沒有人停用過任何東西。它們只是不再被打開了。
沒有一個工具是被正式廢止的。它們都是安靜地不再被打開。
這一篇,我把那張表攤開來講。
這個系列談的東西不是三十天做出來的。把 AI 放進品質流程這件事我斷斷續續做了一段不算短的時間,這 30 篇是整理,不是即時直播;所以這一篇盤點的是那段時間,不是這三十天。
值得先講,因為盤點的價值幾乎全部來自時間長度:一個東西用了兩週還在用什麼都證明不了;用了一年還在用,那才叫留下來。
這張表上有一列比其他都早,而且它不在這段時間裡——它是好幾年前的事。
那是一個透析中低血壓的預警模型。洗腎病人在治療途中血壓掉下來,有時候只是不舒服,有時候不是;而它有一段可以被提前看見的前兆。我們把它做成了一個會提前告訴你的東西。
它跑得起來,而且不是實驗室裡的東西——有排程、有輸入、有一個會亮的畫面,換句話說它已經上線了。當時被反覆討論的模型指標是 87% 的準確率。第四週那篇我已經拿這個 87% 開過一次刀(Day 19),這裡不重複。
那個系統後來的走向我不會在這裡寫——相關的結果會另行發表,這裡不給任何數字,也不給結論。我能寫的是它改掉了我什麼。
它教我的那一課不是模型的問題,是一個預警在螢幕上亮起來之後,接下來會發生什麼:由誰看到、看到之後要做什麼、要花多久、如果那個時段那位護理師手上還有三件事會怎麼樣。這幾件事沒有一件在那個 87% 裡面。
這件事你們每天在做:一條 alert 規則寫得再準,它值多少,取決於被叫起來的那個人接下來能做什麼。
Day 16 講可偵測性的時候我寫過一句「看得見 ≠ 來得及」。那句話不是從教科書來的,是從那個系統來的。
所以這一篇真正的起點在那裡。我現在拿來判斷一個東西該不該留的三個問題,全部是那次留下來的。
品管的最後一步是 Act。教科書上寫「標準化,或者再跑一輪」,但實際上大部分東西會落到第三種狀態:不做,但也沒有正式廢掉。 於是系統裡累積一堆殭屍流程:排程還在跑、報表還在產、沒有人在看——你們叫它 dashboard 墳場。
三個問題,後來變成新東西上線之前就先問一遍的清單:
三個問題有一個共同的形狀:沒有一個在問「它準不準」。
只有四件。比我想像的少很多。
留下來、而且價值最高的那個東西,其實不是 AI。
是為了讓機器判得動,我們被迫把判準寫成可判定的條目(Day 8)。這件事在人工時代永遠做不完,因為不做也能運作——資深的人直接判就好。是機器逼出來的:機器只認得寫下來的那一份。
而結果是:即使把模型整個拿掉,稽核小組內部的一致性也變好了,新人上手變快了,跟單位的爭議變少了——因為爭議終於有一份文字可以指著吵。
活下來的東西有一個共同點:就算把模型拿掉,它還是有用。
這是這段時間我學到最重要的一件事,完全不在當初的預期裡:我以為我在做自動化,結果最大的產出是一份文件。
全量的前置篩選:AI 讀完全部病歷、標出候選、附上依據落在哪一段;人只看候選,外加一份隨機對照樣本(Day 25 那批)。
它活下來的理由不是效果好,是責任鏈沒有被動到(Day 28):它改變的是「人要看什麼」,不是「誰做決定」。所以委員會過得了,第一線也接受得了。
這條對任何內部工具都成立:
你的東西能不能上線,取決於你動了流程的哪一段,不取決於它多準。
動到決定權那一段的,再準都上不去。沒動到的,普通就夠用。
事件通報的欄位萃取(Day 10)。這一步活得最穩,理由很結構性:它離形式化極限最遠。
它做的是抽取,不是評價。輸出可以逐欄檢查——它的失敗長得像一次 schema 驗證失敗,不像一句寫得很好的錯話;而且抽錯一欄,下一關的人補上就好,不會有人為此開會。
這條線後來變成我篩新想法的第一個篩子:這一步是抽取還是評價? 抽取那一端存活率高得離譜;評價那一端的,我後面會講,死了一整排。
最後一個,是自己造的那批問題案例加上定期重跑(Day 22、Day 26)。它不產出任何成果,每個月跑一次,然後告訴我「還沒壞」。
我從來沒想過要停掉它——因為停掉之後,上面那三件我都不敢用了。
唯一一件我從來沒想過要停掉的,是那件不產出任何成果、只用來確認其他東西還沒壞掉的事。
這在 IT 有精確的對應:沒有人會因為 unit test 不產生功能就把它刪掉。但在醫院這種東西非常難編列,因為它的產出是信心,而信心不會出現在任何一張送進委員會的報表上。這是我到現在還沒解決的溝通問題。
比較多,而且有一半是降級不是放棄——這個區別我一開始沒分清楚,講成「放棄」讓幾件還活著的東西聽起來像死了。我認為這一段比上面那一段有用得多。
原因在 Day 13 講過:它穩定往低強度那一端偏,滿口「加強教育訓練」「加強宣導」。
但真正讓我把它拉下來的不是偏,是它對「講具體一點」這個要求的反應方向是錯的:你要它更具體,它會把「加強教育訓練」寫得更長,加上時數、對象、考核方式——而不是換成一個強度更高的做法。它把「具體」理解成「字更多」,不是「介入的層級更前面」。
這是語料分布的問題:訓練資料裡的改善報告本來就滿地都是低強度對策,而且都寫得很詳細。所以判準是:
你修不動一個來自訓練資料分布的偏誤。你只能不要用它做這件事。
降級之後的用法:在改善會議上讓它先丟十個方向給圈長挑,強度一律由人定。它出候選,不出 spec。 這個用法還活著。
理由跟模型強不強完全無關。現象跟原因的區分(Day 14)需要現場知識,而現場知識不在文件裡:通報單記錄的是發生了什麼,不是當時為什麼那樣做——那個「為什麼」從來沒有被寫下來過,它在當事人的記憶裡,通常要開會才問得出來。
這件事給了我一個到現在還天天在用的判準:
如果答案不在輸入裡,換模型是沒有用的。
這句話替我省下的時間比任何一個成功的專案都多。每次有人說「換個更強的模型試試看」,我先問:我們要的那個資訊在輸入裡嗎?大部分時候不在——那不是模型的問題,是取材的問題。
不是完全不用,是不作為驗收依據。自我偏好偏誤是一個問題(Day 23),但真正讓我把它拉下來的是另一件事:驗證系統的錯誤是不可觀測的。
生成的東西錯了我看得出來,因為我有領域知識可以對;評分的東西錯了我看不出來——如果我手上有第二套可靠的標準,我一開始就不需要它了。你用 A 檢查 B,誰檢查 A?沒有標準答案的世界裡,這個遞迴不會停。
它現在的位置是 Day 25 那個分歧抽驗:三個模型判不一樣的那幾份病歷送人看,不決定任何一件事的結論。
先說一件事:這個項目我沒有寫進前面任何一篇,因為它死得太快。 從提出到喊停沒有超過兩個月,中間沒留下任何一個值得單獨寫一篇的教訓。所以它第一次出現就在這張放棄清單上——我覺得這樣反而誠實。
想法很誘人:與其事後稽核,不如在同仁寫紀錄的當下就給提示。這在 IT 是常識——左移,把檢查往前推到最早的地方。
有兩個理由讓我在討論中支持先停下來。第一個是 Day 24 的成本結構:同一個誤判率,在批次裡是雜訊,在即時介面裡是打斷。 而且被打斷的人不會去調參數,他會去想辦法關掉它。
第二個更根本,就是 Day 28 那半篇:即時提示會把品質系統直接變成監控系統。事後稽核看的是已經完成的病歷,即時提示看的是正在打字的那個人——這兩件事在被看的那一端感受完全不同,而感受決定這套東西活多久。
左移是好的工程直覺。但它移動的不只是檢查的時間點,還有被檢查的對象——從文件變成人。
先講清楚沒有變的部分:Day 5 那條分界一步都沒退,真實病歷的判定該在哪裡跑就還在哪裡跑。
降級的是我原本的規劃:我本來想把地端當成主要工作台——生成、造題、各種實驗都往那邊搬,理由是「反正都要維護一台」。後來全部收回來了,地端只跑那條非它不可的路徑,其餘回到自己編的資料那一側(Day 5 的 L0)。
理由不是效果,也不是硬體的錢,是沒有任何一個人的職務描述裡寫著要維護它。模型要更新、環境會壞、要有人看著它,而院內沒有這個職位。資訊室很願意幫忙,但「願意幫忙」跟「這是他的工作」是兩回事:前者在專案期有效,第三年無效。
一個沒有人的職務描述裡寫著要維護它的系統,就是還沒有真正上線的系統。
這件事跟 AI 一點關係都沒有,任何做過內部工具的人都懂。但它殺掉的專案比技術問題多。
早期我們就是把整份病歷丟進去問一句,那是 Day 4 那個坑的延伸。後來拆成多個小任務,理由不是準確率,是可觀測:輸出越大,錯誤的位置越難定位。拆開之後每一步都小到可以逐項檢查,錯了知道錯在哪一步——準確率有沒有變好我其實不確定,但它修得動了,這比準確率重要。
讀到這裡會發現一個缺口:第三週那整套前瞻性分析(Day 15、16、17)沒有出現在上面任何一欄。
不是我忘了,是它兩邊都放不進去。我們確實用 AI 跑過 HFMEA,也真的產出過東西;但它到今天還是「有人想到就開一場」——沒有排程、沒有負責人、沒有下一次的日期。用你們的話:它從來沒有被 deploy 過,一直停在某個人的本機。
按我自己的第一個問題——今天停掉它,一個月內會不會有人來問——答案是不會。所以它其實早就在那張表的下半部了,只是我到寫這一段才正式承認。
三件我沒有放棄、但也還不敢放進正式流程的:
一、分群結果直接進委員會議程。 卡在責任邊界:議程等於決定了一群人接下來花時間看什麼,那是實質決策。現在還是人挑。
二、用覆蓋紀錄自動修訂判準。 資料都在,迴路也接得起來(Day 28)。不敢做的理由是:判準自動修訂,等於沒有人能在委員會上為那一版署名。我還沒想到一個能保住簽名的作法。
三、模型換版的自動閘門。 重跑那批問題案例,不過就不放行——那就是一個 CI 上的 gate,只是斷言長在一致性上。卡在「不過」的門檻要定多少,而目前那個門檻沒有夠強的實證基礎。相關結果會另行發表,這裡不給數字。
把兩邊並排,會看到一個蠻乾淨的分界:
| 留下來的 | 放棄或降級的 |
|---|---|
| 幫忙把判準寫下來 | 代替人做判斷 |
| 抽取 | 評價 |
| 產出候選 | 產出結論 |
| 錯了立刻看得出來 | 錯了要另一套系統才看得出來 |
| 沒有動到誰做決定 | 動到了誰做決定 |
左邊那一欄的共同點是:它們都在幫忙把判準寫下來,或者把已經寫下來的判準執行下去。右邊那一欄的共同點是:它們都在試圖取代判斷本身。
我原本以為這條分界會落在「AI 做得好不好」。這段時間下來,它其實落在另一個地方:
這一步做錯了,看不看得出來。
這條線的名字你們早就有:可觀測性。看得出來的,錯了也留得下來;看不出來的,再準也不敢用。
而放棄或降級的那六件,沒有一件是因為模型不夠強:全部都是因為輸入裡沒有那個資訊、錯了沒人看得見、沒有人的工作是維護它,或者它動到了不該動的那一段流程。
這大概就是最誠實的結論:擋住自動化的,幾乎從來不是模型的能力上限。
而回到那張表最早的那一列——那個 87% 的預警系統。它跟這一整篇的關係是:當年我以為我在量它準不準,其實我該量的是它亮起來的時候,有沒有人來得及為那個病人做什麼。 這件事我花了好幾年才想通,想通之後這張表就好填了。
明天最後一篇,講三件我認為在這件事上一件都沒過時的東西。


 iThome鐵人賽
 看影片追技術